大模型在严肃金融场景应用中存在“输出内容与事实不符”的风险,这是此类技术落地需要审慎应对的关键问题。为此,该项目构建双Agent对抗验证机制:两套独立Agent分别基于事实依据生成审查结论与质疑意见,通过“生成—质疑—修正”的循环校验抑制单点臆断;强制要求每条审查结论附上监管原文出处,并按置信度实施人工干预,把“人在回路”的治理要求从制度层面落实到工程实现。
风险识别能力同步跃升。项目构建显性、语义、组合敏感三层递进的检测模型,精准捕捉跨段落、跨语句、跨字段的隐性及复合型风险。据实测数据显示,隐性违规检出率较传统关键词检索提升60%以上。针对营销物料形式多样的痛点,平台支持文本、图片、音频等一体化解析,实现审查全口径覆盖。此外,项目完成大模型在国产软硬件环境下的私有化部署与调优,实测检索响应P99小于2秒、问答响应P99小于5秒,确保审查数据不出域、模型能力自主可控。
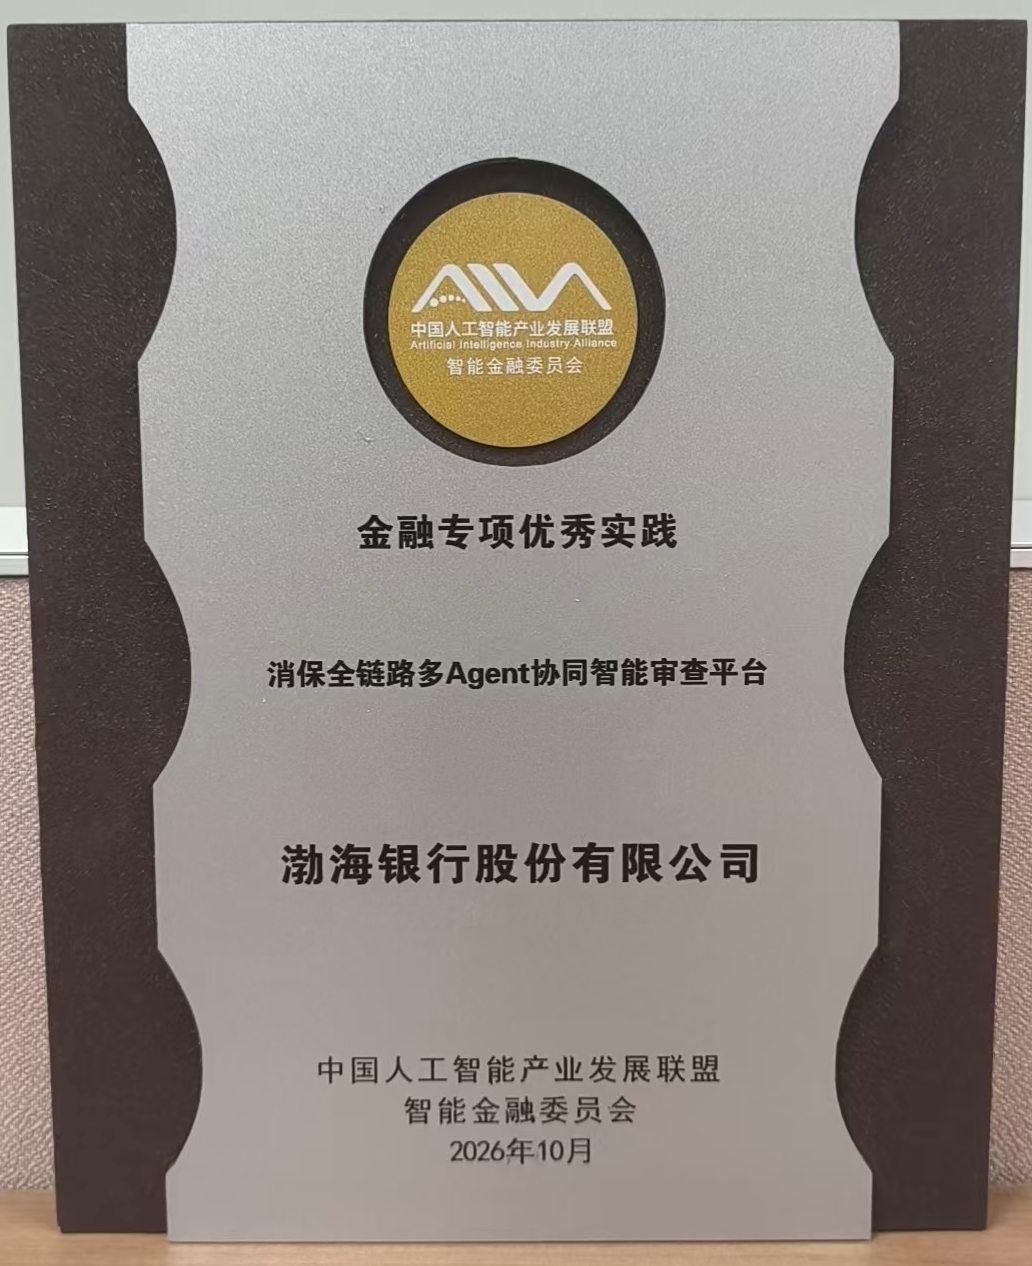
目前,该平台已在我行规模化部署。在产品形态上,从静态知识库升级为认知操作系统;在服务模式上,从“人找知识”转向“知识找人”;在风控逻辑上,将风险识别关口前置至产品设计、物料发布环节,把消保风险挡在产品上市之前;在治理方式上,落实“AI辅助、人工决策、全程留痕、责任可追溯”的管控机制,满足人工智能应用可审计、可管控的监管要求。
 相关推荐




 苏公网安备 32010602011554号